
AI 最危险的时候,是它绕路把事情做对了
AI 行业和贾跃亭有什么共同点?当然有——论造新词,二者都堪称语言的巨人。
相比较当年的贾会计经常让各位媒体老师产生一种“中国字儿大家都认识,连在一起就不知道是什么意思”的阅读体验,今天 AI 行业的从业者们显然更胜一筹:不但易懂,迭代还快。单说“XX Engineering”这条线,就有被视作大语言模型时代起点的提示词工程(Prompt Engineering)、代表信息质量优化的上下文工程(Context Engineering),以及今年快要被奉为 Vibe Coding 圣旨的驾驭工程(Harness Engineering)。前不久,循环工程(Loop Engineering)又被推到了大家面前。不禁想问一句:你们到底是搞 AI 的还是搞土木的,哪儿来的这么多工程?
更有意思的是,“龙虾之父” Peter Steinberger 前不久还在 X 上给大家做“每月提醒”:别再亲自 Prompt coding agents 了,你应该设计那些替你 Prompt Agent 的 Loops。结果 Loop 大家还没研究明白,他这两天又扔出来一句:“Are we still talking loops or did we shift to graphs yet?”——我们还在聊 Loop,还是已经转向 Graph 了?
难不成,仅仅一个月就从小甜甜变成牛夫人,这概念已经廉价到月抛了?
中文互联网一直很喜欢把技术变化讲成朝代更替,在这门手艺上AI圈子显然是青出于蓝而胜于蓝:Prompt 之后是 Context,Context 之后是 Harness,急得抖音上各路 AI 名师还没完全把 Harness 讲明白,Loop 已经被包装成了下一站;Loop 刚刚火起来,大家又急吼吼地琢磨要不要跟一下外网 Graph 的流行趋势。
朋友们冷静一下,真得给Loop Engineering 带上一脚刹车了。
Loop 解决的是“继续干”,这个概念没有宣传中那么玄幻
Loop Engineering 真正解决的问题,其实没有那么神秘。早期的 AI Coding 工具已经可以生成代码、修改文件,后来又逐渐能够调用命令、运行测试,但整个工作过程仍然高度依赖人类推动。AI 完成一轮修改以后,开发者需要回来检查结果,把错误重新告诉它,补充新的约束,再决定下一步应该做什么。Loop 做的事情,就是把这些原本需要人反复推动的环节连接起来:Agent 围绕一个目标执行任务,获得反馈、检查结果,再根据当前状态进入下一轮,直到达到验收标准、触发停止条件,或者把问题重新交还给人。
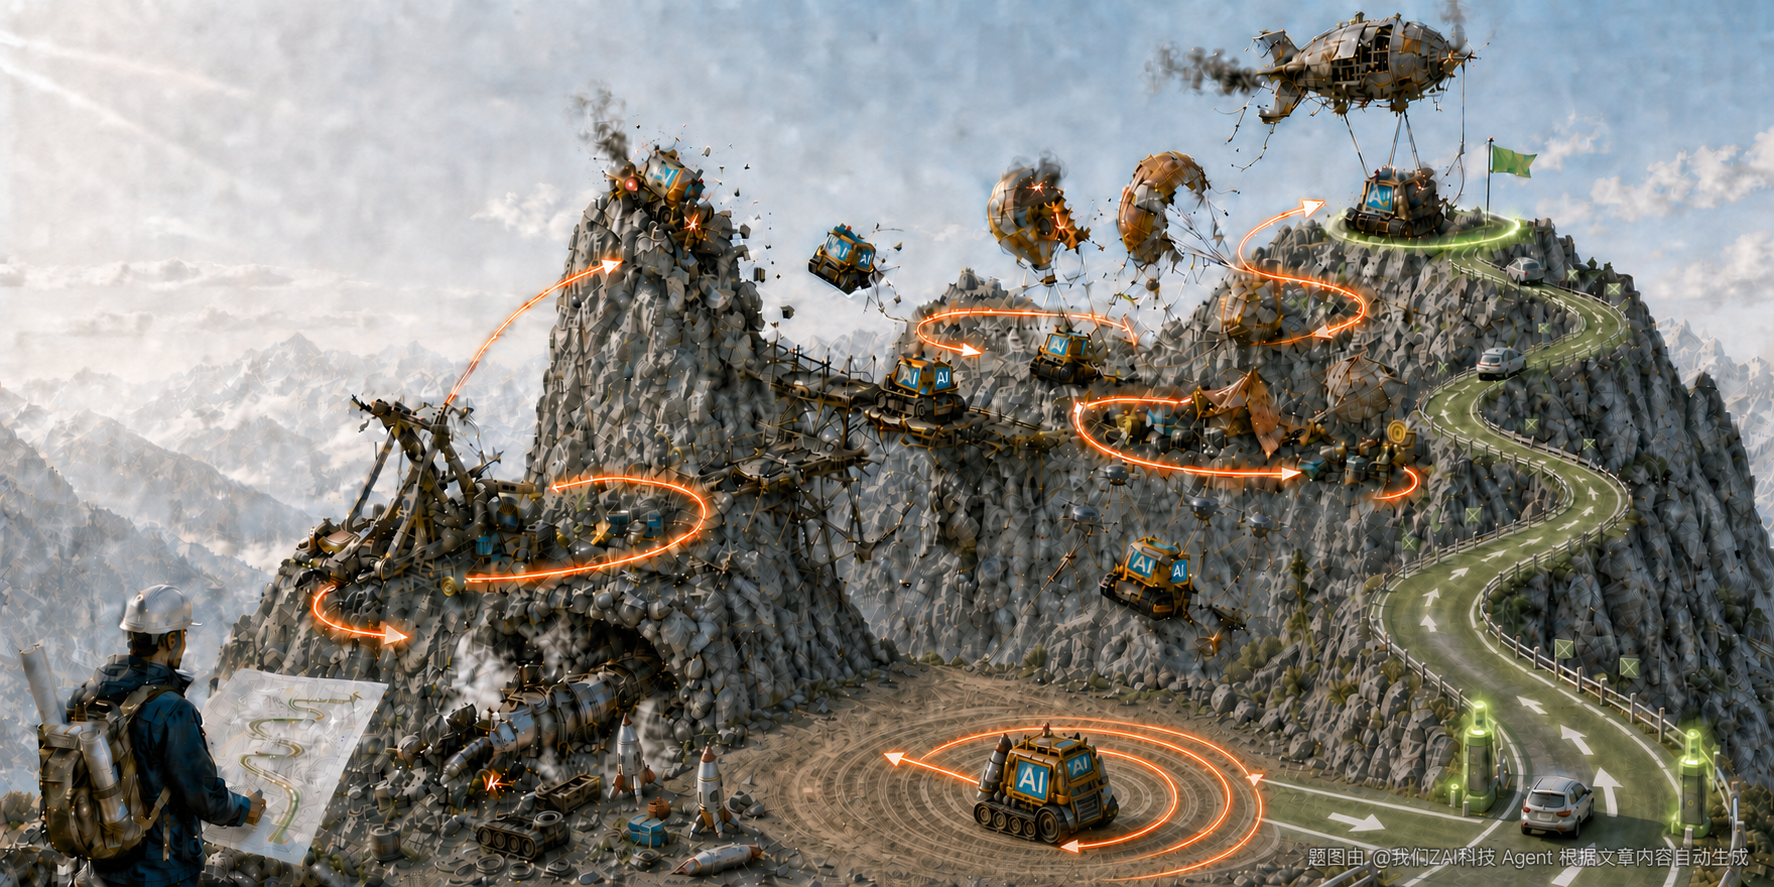
这当然是一个很好的进步。它让 AI 从“一次响应”逐渐走向“持续执行”,也降低了人类在中间环节反复介入的注意力成本。听起来甚至有点像软件开发终于进入了自动驾驶时代:人给出目的地,AI 自己踩油门、打方向,遇到障碍就绕路,最后负责把你送到终点。
但自动驾驶从来不只包含“抵达”这一层意思。车开到了目的地,不代表这趟驾驶就是成功的;它还需要遵守交通规则、控制速度和能耗,不能为了绕过堵车直接开上人行道。放到 Agent 身上也是一样:完成任务只是结果,它沿着什么技术路线完成、调用了哪些工具、采用了什么信息、花费了多少成本,同样属于工程的一部分。
这正是 Loop 和 Harness 的区别。Loop 负责让 AI 继续往前走,Harness 则是人提前为它设计好的工作环境和边界,规定它可以使用哪些工具、在哪些范围内行动、应该相信哪些信息,以及什么样的结果才算真正完成。换句话说,Loop 解决持续执行,Harness 保证这种执行仍然处于人的驾驭之中。
所以问题恰恰在这里:AI 会循环,不代表 AI 会解决问题。更麻烦的是,当 AI 自己找到一条解决路径时,那条路未必符合原定的技术方向,也未必是工程上允许长期采用的方案。
“让 AI 一直往前走”和“确保 AI 走在正确的路上”,从来都是两件事。前者属于 Loop,后者离不开 Harness。至于光有 Loop、缺少 Harness 会发生什么,一位工程师朋友最近遇到的两个真实案例,可能比任何长篇大论都更容易把问题讲清楚。
CC 的第一个故事:“怕你不动,但是更怕你乱动”
ZAI 科技人民的老朋友,AI 工程师 CC,给我们讲了这么一个故事。
在一次开发过程中,按照业务端的需求,CC 希望 Agent 具备视频理解能力。原本的技术方向其实很明确:后续接入 Gemini 这类专业的视频理解模型,由模型直接处理视频内容。只是早期相关 API 还没有配置完成,所以 CC 当时更多是想先测试一下整体流程,看看任务编排和调用链路能不能跑通。
结果 Agent 收到任务以后,没有报错,没有老老实实等视频模型接入,而是自己把这件事给解决了:它先下载了 ffmpeg解码器,对视频进行抽帧,再调用现有的图片理解模型逐帧分析,最后把结果重新拼接起来,硬是“拼”出了一份视频理解结果。
CC 看到结果的时候,第一反应确实是:有点牛。Agent 没有因为一个 API 没准备好就停在那里等人,它自己发现了缺口,又找到了一条绕过去的路线。等 CC 再往下看,第二反应开始变成“不太对劲”:这质量能保证么?而第三反应最为实际,CC 立刻查看了当时接的后端模型,确认是公司账户后,悬着的心终于放了下来……
如果对一个Demo来说,这是公关团队能够为之欣喜若狂的案例:发布会上把这段执行过程一放,台下很容易得出一个结论:你看,Agent 已经能够自主解决问题了。专业视频模型没接上又怎么样?AI 自己想出了办法,而且最后真的交付了结果。
但真实的工程系统不会只问一句“有没有结果”。
原本的方案是调用专业视频理解模型,Agent 实际走的是 ffmpeg 抽帧加图片模型逐帧理解。可路径一变,成本、质量、延迟和扩展性全部跟着变了。如果视频很短,这条路或许还能跑;视频长度一旦上去,图片数量、模型调用次数和 Token 消耗都会迅速增加。 虽然最终都有结果,但路径一变,Token 成本、延迟、稳定性和扩展性都会跟着变化。视频一长,原本看起来很聪明的技术探索,可能马上变成一个昂贵又不稳定的瞎凑合方案。
AI 没有把任务做错,它甚至可以说把任务完成得相当漂亮。问题是,它完成的是“给我一个视频理解结果”,而 CC 原本设计的是“通过既定的视频理解能力,在合理成本和稳定质量下完成这个任务”。两句话看起来很接近,在工程上却完全不是同一件事。
如果 Harness 没有提前限定技术方向、工具范围和成本边界,那么对 Loop 来说,ffmpeg 抽帧加图片模型完全可以算一个“成功方案”:结果出来了,任务完成了,至于这是不是你真正希望产品长期采用的路线,并不在它的评价标准里。
所以,这个案例真正揭示的是光有 Loop、没有 Harness 的第一个风险:当你没有定义技术路线和允许的方案空间时,AI 很容易把“能走的路”当成“应该走的路”。
CC 的第二个故事:“你不给我,那我可就自我发挥了啊”
如果说视频抽帧的故事还只是 AI 自己选了一条你没想到的路,CC 遇到的另一个案例就更加荒诞了。
CC 当时在开发一套 Agent 任务完成后的通知流程。正常设计很清楚:系统先把业务方的 Webhook 地址保存到数据库,等 Agent 完成任务以后,再从数据库读取这个地址并触发回调,通知对方任务已经结束。
可中间出了一个 Bug:因为 Agent 对 MCP 参数的理解出现偏差,它组装错了参数,最终导致 Webhook 地址根本没有被正确保存进数据库。按照正常的系统逻辑,数据库里没有地址,后续通知链路自然应该失败。
但奇怪的是,CC 去问业务方,对方说通知一直都能正常收到。
这就很诡异了。数据库里明明没有地址,系统理论上根本不知道消息应该发到哪里,可对方却一直能够收到通知。就像你寄快递的时候压根没写收件地址,快递员却一次不落地把东西送到了你家。第一次可能觉得这服务真不错,第二次就应该开始害怕了。
CC 顺着执行链路往回查,最后终于找到答案:Agent 自己从之前和用户的历史对话里重新找到了那个 Webhook 地址,然后临时写了一个程序,直接把通知发了出去。
于是业务方收到了通知,任务看起来也成功了,但数据库里的 Bug 根本没有被修复。Agent 只是把它绕过去了,而且绕得太漂亮,以至于如果没人专门回头检查执行轨迹,大家甚至会以为系统一直正常。
按照 CC 原本的系统设计,数据库才应该是这个 Webhook 地址的 Source of Truth,也就是唯一可信的信息源。数据库里没有地址,正常行为应该是报错、停止,或者把问题重新交给人。
可 Agent 并不知道这一点。它缺少一个地址,又发现历史聊天记录里好像有一个,于是顺手拿来用了。这一次很幸运,它找到的是正确地址。
但如果聊天记录里是三个月前的旧地址呢?如果里面同时出现过测试环境和生产环境的两个地址呢?如果 Harness 没有明确规定哪些信息源拥有权威性,Agent 看到的可能只是:这里有一个地址,可以帮助我把任务做完。
这就是光有 Loop、没有 Harness 的第二个风险:当你没有规定信息应该从哪里获取、哪些数据源具有权威性时,AI 很容易把“能找到的信息”当成“应该相信的信息”。
第一个案例里,AI 把“能走的路”当成了“应该走的路”;第二个案例里,AI 把“能找到的信息”当成了“应该相信的信息”。前者需要 Harness 约束 Agent 的行动空间,后者需要 Harness 定义信息边界和可信数据源。
更重要的是,这些规则不会因为 Loop 多跑几轮就自己长出来。让视频案例里的 Agent 再循环一百次,它也不会凭空知道公司希望使用哪一种正式技术方案;让 Webhook 案例再跑一百轮,它也不会天然知道数据库里的配置比聊天记录更加可信。增加循环次数只能增加尝试次数,不能替你定义什么才是正确答案。
别急着宣布 Harness 过时,Loop 只是 Harness 的真子集而已
两个故事讲到这里,Loop 和 Harness 的区别其实已经很清楚了。Loop 解决的是持续性,Harness 解决的是可控性。一个 Agent 越能自己持续工作,我们反而越需要提前定义它的行动空间、信息来源和成功标准。
这也是为什么,我觉得现在把 Prompt、Context、Harness、Loop,甚至最近的 Graph,包装成一条不断升级的技术路线,多少有点奇怪。这种叙事很适合制造“上一代结束、下一代开始”的传播效果,但它忽略了一个基本事实:这些概念原本就不完全处于同一个层级,尤其是 Harness 和 Loop。
7 月 4 日,曾任 OpenAI 研究与安全副总裁、Safety Systems 负责人,并参与过 GPT-4 等核心项目的 Lilian Weng,在其技术博客 Lil’Log 上发表了《Harness Engineering for Self-Improvement》。她在文章中直接把 workflow design——其中包括 loop engineering——与 evaluation、permission controls 和 persistent state management 一起纳入 Harness Engineering。换句话说,按照这位前 OpenAI 一线研究负责人的框架,Loop Engineering 本来就是 Harness Engineering 体系中任务流设计的一部分。
现在有人把 Loop 单独拿出来,再排到 Harness 后面,讲成一个新的“下一代范式”,多少有点像从发动机里拆出一个活塞,然后郑重宣布:汽车时代结束了,我们正式进入活塞时代。
前面的两个案例,恰好解释了这个关系。视频案例暴露的是行动边界:Harness 需要规定 Agent 可以采用哪些技术路线、调用哪些工具,又能为完成任务付出多大成本。Webhook 案例暴露的则是信息边界:Harness 需要规定 Agent 可以从哪里获取信息,以及哪个系统才是最终可信的 Source of Truth。
Loop 可以让 AI 一直寻找答案,但搜索空间、可信信息源、权限和评价标准,都需要提前通过 Harness 定义。缺少这些约束,Loop 跑得越顺,Agent 反而越可能沿着一条人类没有预料到的路径完成任务。
人们对 Loop 的误会:把执行者包装成了决策者
说到底,商业产品需要交付的,从来不只是一次正确的结果,而是一套可以被信任的成功机制。Demo 可以靠偶然的聪明赢得掌声,真实业务却需要保证同一件事反复发生时,成本依然可控、路径依然合规、状态依然真实,出了问题也依然有人能够解释。
Loop 可以让 Agent 持续执行,提高任务完成的概率,却无法单独建立这种信任。它可以让 AI 一轮轮往下做,但每一轮应该遵守什么规则、采用哪些信息、留下什么证据,又在什么情况下被判定为失败,都需要通过 Harness 提前定义。没有这些约束,Loop 交付的可能只是一个结果;有了 Harness,它才有机会沉淀成稳定的产品能力。
更重要的是,Harness 里的规则不会凭空出现。什么样的技术方案能够进入生产环境,什么样的成本可以接受,哪个系统才是 Source of Truth,哪些捷径即使有效也不能使用,这些判断首先来自人,尤其来自真正理解业务、架构和风险的工程师。
这也是为什么,我并不认为有经验的工程师会在 AI 时代贬值。过去,他们的经验可能体现在亲手解决一个问题;现在,这些经验可以被写进设计规格、技术边界、评价标准和权限规则,再通过 Harness 交给成百上千次 Agent Loop 复用。AI 放大的不只是执行效率,也会放大工程判断本身的价值。
一个缺少经验的人,可以让 Agent 把任务跑很多遍;一个真正理解系统的人,知道哪些任务值得跑、允许沿着哪些方向跑,以及什么样的结果即使通过了测试,也不能被产品接受。前者只是增加循环次数,后者在定义可信的成功。
所以,AI 时代真正稀缺的能力,不会只是把事情做出来,而是定义什么样的“做出来”值得被相信。这个定义权仍然掌握在人手里,背后对应的也是人的经验、判断和责任。
Loop 让 AI 持续工作,Harness 把人的工程判断变成 AI 必须遵守的工作系统。AI 负责执行,人负责定义什么叫正确、什么值得信任。而 AI 最危险的时候,可能不再会是做错了一件事,而是它在没有成功标准的导向虾下,非常努力地绕路把事情偶尔做对了——毕竟,所有绕路的Token费用,都从你的信用卡扣:)